UNIXという考え方を読んで
先日、UNIXという考え方という書籍を読みました
発売から10年以上経っていますが、現代にも通じるような内容でした
書籍では、以下の9つの定理(UNIX哲学)について、著者の体験談や例え話を用いて説明されています
- 定理1:スモール・イズ・ビューティフル
- 定理2:一つのプログラムには一つのことをうまくやらせる
- 定理3:できるだけ早く試作を作成する
- 定理4:効率より移植性
- 定理5:数値データはASCIIフラットファイルに保持する
- 定理6:ソフトウェアの梃子を有効に活用する
- 定理7:シェルスクリプトを使うことで梃子の効果と移植性を高める
- 定理8:過度の対話的インタフェースを避ける
- 定理9:すべてのプログラムをフィルタとして使う
また、必須ではないとしつつ、以下の10の考え方についても説明があります
- 好みに応じて自分で環境を調整できるようにする
- オペレーティングシステムのカーネルを小さく軽くする
- 小文字を使い、短く
- 森林を守る
- 沈黙は金
- 並行して考える
- 部分の総和は全体よりも大きい
- 90パーセントの解を目指す
- 劣る方が優れている
- 階層的に考える
例えば、スモール・イズ・ビューティフルはプログラムは小さくシンプルに作る・1つのプログラムには1つの機能だけを持たるということを意味しています
これはプログラムに関して勉強した人はなんとなく聞いたことあるような内容だと思います
今回は、自分が知らなかったことやよくわからなかったことを噛み砕いてまとめようと思います
過度の対話的インタフェースを避ける
プログラムは人間との会話ではなく、他のプログラムとの連携を前提に設計するべきということだと感じました
対話的インタフェースとは、たとえばこういうプログラムです
$ rm filename.txt
削除するファイル名を入力してください: filename.txt
本当に削除しますか? (y/n): y
削除しました。続けますか? (y/n): n
上記は自動化できない点が問題です。スクリプトや別のプログラムからこのコマンドを呼び出そうとしても、途中で入力待ちになって止まります
UNIXが目指すのは下記です
# 対話なしで動く → スクリプトに組み込める
$ rm foo.txt

# パイプでつなげる
$ find . -name "*.tmp" | xargs rm
人間が毎回手で操作しなくても、プログラム同士をパイプや引数でつなぎ合わせて自動化できることを重視しています
対話を増やすほど、そのプログラムは単独でしか使えない閉じた道具になってしまいます。UNIXの強さはプログラムを組み合わせる哲学にあるので、その組み合わせを邪魔するなという理念があるようです
現代システムはあれこれと機能などを入れ過ぎて、無駄なアクションが入り過ぎているのかしれません
すべてのプログラムをフィルタとして設計せよ
フィルタとはなんでしょうか?
私は、プログラムはデータを生み出すものではなく、データを変換するものとして設計するものだとと捉えました。
何かしらのデータを入力として受け入れて、何かしらをフィルタし、それを標準出力するのがUNIXの思想です
例えば、下記のコマンドを見てください
# それぞれが「フィルタ」として機能している
$ cat access.log | grep "ERROR" | cut -d' ' -f3 | sort | uniq -c
cat、grep、cut、sort、uniq -cはそれぞれ入力を受け取って加工して出力しています
データを生み出すシステムは入力も出力も自分で抱え込んでいて、他とつなげられない閉じたプログラムになってしまうからだと推測しています
結局は他の定理と重複しますが、プログラムは組み合わせられてこそ価値があるということだと思います
ソフトウェアの梃子を有効に活用する
梃子という表現が最初はよくわかりませんでした
1つのプログラムの結果をもらい、その力を使って別の問題を解決するというイメージだと思っています
例えば、ライブラリを使用して新たにコードをゼロから書かず、目的を達成することやシェルのパイプラインなども梃子に相当すると思っています
部分の総和は全体よりも大きい
1つのプログラムをできるだけ小さくする・1つの機能だけ受け持たせ、それをパイプなどでつなぐ方が1つの大きなプログラムを作るより、将来の変化に対して強いなどのメリットがあるという考え方だと認識しています
マイクロサービスなどもこの考え方に近いのかなと思いました
森林を守る
紙の文書はデータの検索性や編集性を著しく低下させます。 データをそのまま電子テキストで保持することで、ソフトウェアによる再利用が可能になります。
なぜ、森林という表現が使われているのか気になったのですが、ペーパレスにすることで木を守るという意味と、ツリー構造になっているフォルダを守るという2つの意味があるのではないかと個人的に感じました(2つ目は飛躍し過ぎているかもしれないですが...)
最後に
個人的に学びになった箇所や噛み砕いて理解した場所をまとめました。 主観が入っている可能性が高いものもありますが、いろいろな考えがあっていいと思います。 自分に置き換えて、今後の判断軸に使えるような良い書籍だと感じました
Rubyのクラスメソッド、インスタンスメソッドについて
今回はRubyのクラスメソッド、インスタンスメソッドついて記載しようと思います
まず、下記コードがあるとします
class Test
  def self.start
    # 処理
  end
end
メソッド名の前にselfがついています。他の言語でも見たことあると思いますが、これはなんでしょうか?
クラスメソッド
クラスメソッドはクラスから呼び出す事ができるメソッドです
Ruby におけるクラスメソッドとはクラスの特異メソッド(クラスではなくある特定のオブジェクトに固有のメソッド)のことです
# 特異メソッド方式。
class Test
  def Test.start
  end
end

# クラス定義の外でも良い
def Test.start
end

# 以下のようにすればクラス名が変わってもメソッド部の変更が不要
class Test
  def self.start
  end
end

# 特異クラス方式。複数のメソッドを一度に定義するとき向き
class << Test
  def bar
  end
end
なので、メソッドの前にselfがついているメソッドはクラス名.メソッド名で実行することができます(上記の例であれば、Test.start)
上記とは別の方法で定義することもできます
class Test
  class << self
    def hello
      puts "Hello!"
    end
  end
end
上記のように、class << selfを追加するとクラスオブジェクトにメソッドが追加されます
なので、class << selfの部分をclass << Testにしても動きます
では、class << selfとself.メソッド名はどちらがいいのでしょうか?
それぞれ以下のような特徴があります
self.メソッド名
- クラスメソッドというのがぱっと見、わかりやすい
- メソッドが散在していても、それぞれが独立して理解しやすい
self.をつけるので、多少冗長
class << self
attr_accessorをクラスレベルで使える- privateなクラスメソッドを定義しやすい
- ネストが1段深くなる
場合によっては、class << selfを使わざるを得ない場合があると思いますが、そうでなければプロジェクトのガイドラインによると思います
デフォルトではメソッド定義がクラス定義の外にあれば private、クラス定義の中にあれば public に定義します
これはModule#public、Module#private、Module#protectedを用いて変更できます。ただしObject#initializeという名前のメソッドとObject#initialize_copyという名前のメソッドは定義する場所に関係なく常にprivateになります。
def foo           # デフォルトは private
end

class Test
  def start         # デフォルトは public
  end

  def end          # デフォルトは public
  end
  private :end     # private に変わる

  def initialize  # initialize は private
  end
end

class Test
  def self.start
  end

  private_class_method :start  # private_class_methodでもprivate に変わる
end
インスタンスメソッド
インスタンスメソッドはクラスのインスタンスに対して呼び出すことのできるメソッドです
クラス内の内部で以下のようにメソッド定義を行うとインスタンスメソッドになります
class Test
  def greet
    puts "Hello!"
  end
end

test = Test.new
test.greet  #  "Hello!"
クラスメソッドとインスタンスメソッド どう使い分けるの?
ここまででクラスメソッドとインスタンスメソッドどう使い分けるのか疑問に思った方もいらっしゃると思います
自分の中では、明確な基準は正直ないです
ただ、大まかな考え方はあるのでまとめようと思います
①迷ったらまずはインスタンスメソッドでやってみて、場合によってはクラスメソッドに変える
②インスタンス変数を全く使っていない(読み書き)のであればクラスメソッドを検討する
③新しいインスタンスを生成する場合、クラスメソッドを使う
Date.parse("2026-01-27")などです。例えば、date = Date.todayにしてdate.parse("2026-01-27")とすることはないというより無駄が多すぎると思います
④特定のインスタンスに向けてではなく、汎用的に使う場合にはクラスメソッドを使う
# データをCSVダウンロード
dog = Dog.new('ぽち')
Dog.download_csv(dog) # こっちの方が違和感ない

# ぽちが他のDogのデータをCSVダウンロードするのは違和感
dog.download_csv(other_dog)
上記はインスタンスメソッドになっていると違和感を感じるのでクラスメソッドを使った方がよさそうです
参照
Rubyのコードはどうやって実行される?
今回はRubyのコードがどのような流れで実行されるのかをまとめます
rubyコマンドを実行してからコンソールに結果が出力されるまでに下記の手順を行います
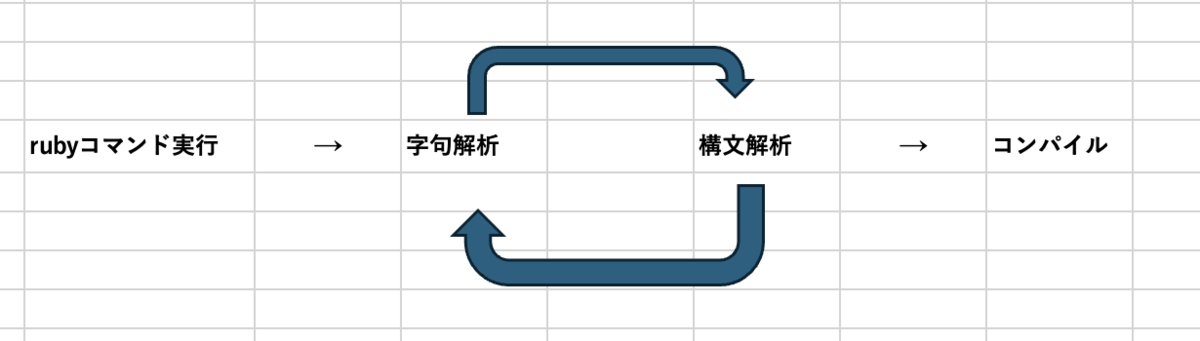
それぞれの手順を細かく見ていきます
字句解析
字句解析とはソースコードを読み込んで、トークン列へと変換することです
Rubyコードは字句解析でトークン列に変換され、次の構文解析のプロセスを行います
ただし、全トークンを事前に生成するわけではなく、必要な分だけ順次トークン化していく(構文解析の中で字句解析が呼び出される形)ので字句解析は何回も行われます。
def hello(name)
  puts "Hello, #{name}"
end
例えば上記の処理があるとします
- def → キーワード(tDEF)
- hello → 識別子(tIDENTIFIER)
- ( → 左括弧(tLPAREN)
- name → 識別子(tIDENTIFIER)
- ) → 右括弧(tRPAREN)
- 改行 → 終端記号(tNL)
- puts → 識別子(tIDENTIFIER)
- "Hello, #{name}" → 文字列リテラル(tSTRING)
- end → キーワード(tEND)
字句解析では、空白やコメントの除去、キーワードと識別子の区別、数値リテラル、文字列リテラルの認識、演算子や記号の認識、文字列補間の処理などを行います(文字列の読み取り、トークンの識別、トークンの分類)
元々は字句解析にはparse.yを使用していましたが、Ruby3.3以降はPrismを使用して字句解析を行っています
構文解析
構文解析とはRubyが分かるように、トークン列をグループ化する作業です
トークン列を文法のルールに従ってグループ化し、コードの構造を木構造(AST)で表現します
下記のようにDefNodeがdefの部分であり、ノードの開始となります。そこから木構造でノードを追加していきます。下記はPrismを使用した際のASTです
DefNode (メソッド定義ノード)
├─ name: "hello"
│   └─ type: Symbol
│   └─ value: :hello
│   └─ location: (1,4)-(1,9)
│
├─ parameters: ParametersNode (パラメータノード)
│   ├─ requireds: Array
│   │   └─ [0] RequiredParameterNode
│   │       ├─ name: "name"
│   │       ├─ type: Symbol
│   │       ├─ value: :name
│   │       └─ location: (1,10)-(1,14)
│   │
│   ├─ optionals: [] (空)
│   ├─ rest: nil
│   ├─ posts: [] (空)
│   ├─ keywords: [] (空)
│   ├─ keyword_rest: nil
│   └─ block: nil
│
├─ body: StatementsNode (文のリストノード)
│   └─ body: Array
│       └─ [0] CallNode (メソッド呼び出しノード)
│           ├─ receiver: nil (レシーバなし、トップレベル)
│           │
│           ├─ call_operator: nil
│           │
│           ├─ name: "puts"
│           │   └─ type: Symbol
│           │   └─ value: :puts
│           │
│           ├─ message_loc: (2,2)-(2,6)
│           │
│           ├─ opening_loc: nil (括弧なし)
│           │
│           ├─ arguments: ArgumentsNode (引数ノード)
│           │   └─ arguments: Array
│           │       └─ [0] InterpolatedStringNode (式展開文字列ノード)
│           │           ├─ opening_loc: (2,7)-(2,8) (")
│           │           │
│           │           ├─ parts: Array
│           │           │   ├─ [0] StringNode (通常文字列部分)
│           │           │   │   ├─ flags: FORCED_UTF8_ENCODING
│           │           │   │   ├─ content: "Hello, "
│           │           │   │   ├─ unescaped: "Hello, "
│           │           │   │   └─ location: (2,8)-(2,15)
│           │           │   │
│           │           │   └─ [1] EmbeddedStatementsNode (式展開部分)
│           │           │       ├─ opening_loc: (2,15)-(2,17) (#{)
│           │           │       │
│           │           │       ├─ statements: StatementsNode
│           │           │       │   └─ body: Array
│           │           │       │       └─ [0] LocalVariableReadNode
│           │           │       │           ├─ name: "name"
│           │           │       │           ├─ type: Symbol
│           │           │       │           ├─ value: :name
│           │           │       │           ├─ depth: 0 (スコープの深さ)
│           │           │       │           └─ location: (2,17)-(2,21)
│           │           │       │
│           │           │       ├─ closing_loc: (2,21)-(2,22) (})
│           │           │       └─ location: (2,15)-(2,22)
│           │           │
│           │           ├─ closing_loc: (2,22)-(2,23) (")
│           │           └─ location: (2,7)-(2,23)
│           │
│           ├─ closing_loc: nil
│           ├─ block: nil (ブロックなし)
│           ├─ flags: IGNORE_VISIBILITY
│           └─ location: (2,2)-(2,23)
│
├─ locals: ["name"] (ローカル変数のリスト)
│
├─ def_keyword_loc: (1,0)-(1,3) (def)
│
├─ operator_loc: nil
│
├─ lparen_loc: (1,9)-(1,10) (()
│
├─ rparen_loc: (1,14)-(1,15) ())
│
├─ equal_loc: nil
│
├─ end_keyword_loc: (3,0)-(3,3) (end)
│
└─ location: (1,0)-(3,3) (全体の位置)
ちなみに、構文解析器は再帰下降パーサーまたはLR(LALR)パーサーの手法を使っています
コンパイル
コンパイルとは、コードをプログラミング言語から別の言語(ターゲット言語)に変えることです
Rubyのインタプリタがコードを読み込み、木構造(AST)からYARVのバイトコード命令列に変換します
AST構造をYARV命令にコンパイルするために、Rubyは木構造の一番上から再帰的にツリーを反復しながら、それぞれのASTノードをYARY命令に変換していきます
ASTノードにはノードタイプが定義されているので、ノードタイプに一致するYARY命令に変換します。例えば、NODE_CALLはputself + opt_send_without_blockに変換されます
コンパイルすると下記のようになります
== disasm: #<ISeq:<compiled>@<compiled>:1 (1,0)-(3,3)> (catch: FALSE)
0000 putspecialobject             1                                   (   1)[Li]
0002 putobject                    :hello
0004 putiseq                      hello
0006 opt_send_without_block       <callinfo!mid:core#define_method, argc:2, ARGS_SIMPLE>, <callcache>
0009 leave

== disasm: #<ISeq:hello@<compiled>:1 (1,0)-(3,3)> (catch: FALSE)
local table (size: 1, argc: 1 [opts: 0, rest: -1, post: 0, block: -1, kw: -1@-1, kwrest: -1])
[ 1] name@0<Arg>
0000 putself                                                          (   2)[LiCa]
0001 putobject                    "Hello, "
0003 getlocal_WC_0                name@0
0005 dup
0006 checktype                    T_STRING
0008 branchif                     15
0010 dup
0011 opt_send_without_block       <callinfo!mid:to_s, argc:0, FCALL|ARGS_SIMPLE>, <callcache>
0014 tostring
0015 concatstrings                2
0017 opt_send_without_block       <callinfo!mid:puts, argc:1, FCALL|ARGS_SIMPLE>, <callcache>
0020 leave                                                            (   3)[Re]
1つ目の命令列はメソッド定義部分で、2つ目の命令列はメソッド本体部分を表しています
コンパイラはまず、ASTのルートノードを見てDefNode(メソッド定義)を発見します。DefNodeを発見するとメソッド本体(body部分)を別の命令列(ISeq)としてコンパイルして、 トップレベルにはメソッドを定義する命令だけ生成します。
実行
補足程度ですが、コンパイルされたバイトコード命令列を実行するときにYARVがバイトコード実行するのですが、JITコンパイラを有効にしている場合にはバイトコードを最適化してくれます
何回も呼ばれている処理はホットスポットとして検出して、YARVバイトコードをx86/ARM機械語に変換します。以降は機械語を直接実行することで、大幅に高速化されます
そして、Ruby 3.1以降ではYJITというオプションで有効にできるJITコンパイラがあり、実行時にバイトコードを機械語に変換して高速化します
Ruby 3.3以降では、RJITというMJITの後継となる新しいJITコンパイラがあります。MJITは実行時にCコンパイラが必要で、YJITはビルド時にRustコンパイラが必要ですが、RJITはどちらも不要です
参照
2024年の振り返りと今年の目標
ブログを更新できておらず、間が空いてしまいました.....
今年がもう2ヶ月経っているこのタイミングで去年の振り返りと今年の目標を書こうと思います
去年の振り返り
去年の大きな変化としては、モバイルアプリエンジニアからバックエンドエンジニアになったことです
今ではRailsでバックエンドの開発をしています
Railsは若干他の言語に比べてクセがあるので勉強の日々です。 また、設計一つにとってもモバイル開発と比較して考慮するポイントが全然違うので新鮮です
あと、SQL使うのが久しぶりなので思い出すために勉強していました
モバイル開発が嫌いになったわけではないので、個人的に細々とやっています
ただ、今後はバックエンド関連の記事が多くなると思いますので、ご了承ください!!
また、OSS貢献も新たな試みとして行いました。
Railsのドキュメント修正ではあるのですが、自分の中でOSS貢献のハードルが下がりました。
今年の目標
バックエンドの経験を積む!はい、これにつきます
その延長でドキュメントではないコード部分のOSS貢献やライブラリを作成などチャレンジしていきたいです
その他の目標はイベント登壇など外部に向けたアウトプットも最近はできていないので、チャレンジできるといいかなと思っています
エンジニア以外では少しは関連しているかもですが、英語の学習を進めたいです
少なくとも洋書はある程度読めるようにしたいのと、海外のカンファレンスなど聞き取れるようにしたいです
最後に
今年の年末に答え合わせをできるように記録に残します
Railsのアソシエーションについて
今回はRailsのアソシエーションについて記載します。
アソシエーションとは?
Railsでは、アソシエーションという機能が存在し、モデルとモデルを関連付けすることによって他モデルのデータも合わせて操作することができます。
例えば、userの投稿したpostを全件取得したい場合、アソシエーションの設定を行っていない場合には、whereメソッドを用いる必要があります。
user = User.find(1)
posts = Post.where(user_id: user.id)
これがアソシエーションの設定を行っていた場合、以下のように書くことができます。
user = User.find(1)
posts = user.posts
使用できるアソシエーション
ここからは設定できるアソシエーションについて確認していきます。
belongs_to
belongs_toは他のモデルに所属している場合に使用します。
あるモデルでbelongs_to関連付けを行なうと、宣言を行ったモデルの各インスタンスは、他方のモデルのインスタンスに所属します。
belongs_toの説明のために商品とレビューの関係について説明します。
例えば、イヤフォンの商品説明ページがあるとします。そこに1件のレビューされていたとして、belongs_toは商品につけるのでしょうか?もしくはレビューにつけるのでしょうか?
belongs_toはレビューに設定します。レビューが商品に必ず属しています。レビューは商品がなければ存在しないので、商品にレビューが所属していると考えます。
モデルは下記のように表します。
class Product < ApplicationRecord
end

class Review < ApplicationRecord
  belongs_to :product
end
belongs_to :productのように所属先のモデルを単数で指定します。
どちらにbelongs_toを設定するか迷った時には外部キーをどちらに置くか考えるといいと思います。
外部キーを持つ方にbelongs_toを設定するのが望ましいです。
実際にテーブルを検討すると下記のようになると思います。
・Productテーブル
| id | product_name |
|---|---|
| 1 | イヤフォンA |
| 2 | イヤフォンA |
・Reviewテーブル
| id | product_id | review_point |
|---|---|---|
| 1 | 1 | 100 |
| 2 | 1 | 70 |
| 2 | 2 | 30 |
Reviewテーブルには外部キーのproduct_idを作成してどの商品のレビューかわかるようにしています。 なので、今回はReviewにbelongs_toを設定します。
has_one
has_oneはモデル同士が1対1の関係の場合に使用します。
class User < ApplicationRecord
  has_one :profile
end

class Profile < ApplicationRecord
  belongs_to :user
end
例えば、上記のようなuser各々がprofileを持っている場合です。
外部キーを持つ側にbelongs_toを使用し、外部キーを持たない側がhas_oneを使用するというのが基本的な使い分けになります。
下記のようにすることでプロフィールの情報を取得できます。
user = User.find(1)
// プロフィール情報の取得
user.profile
has_many
has_manyはモデル同士が1対多の関係の場合に使用します。
belongs_toのときに使った商品とレビューの例をもとに説明します。
belongs_toの説明の際には商品1つに対してレビューが1つという条件で説明しました。 実際には商品1つに対して、レビューは複数のパターンはありえます。
1対多の関係の場合にはhas_manyを下記のように設定します。
class Product < ApplicationRecord
  has_many :reviews
end

class Review < ApplicationRecord
  belongs_to :product
end
has_many関連付けを宣言する場合、相手のモデル名は複数形で指定する必要があるので、注意が必要です。
商品に紐づいたレビューの情報の一覧は下記方法で取得できます。
product = Product.find(1)
product.reviews
has_one :through
has_one :throughは1対1のつながりの2つのモデルの間に第3のモデルが紐づいており、それを経由して相手モデルの1個のインスタンスとマッチします。
例えば、userは一つのpostを持ち、postは一つのtagを持つとします。 その場合以下のように構造を表現することが出来ます。
class User < ApplicationRecord
  has_one :post
  has_one :tag, through: :post
end

class Post < ApplicationRecord
  belongs_to :user
  has_one :tag
end

class Tag < ApplicationRecord
  belongs_to :post
end
user has one postとpost has one tagという関連性がまず存在します。
そして、Userはhas_one :tag, through: :postというようにPostを経由してTagが1つ紐づいていることを表します。
こうすることで、Userから直接紐づいているTagを取得できます。
user = User.find(1)
tag = user.tag
PostモデルがUserとTagの間の仲介モデルとして機能しています。 Postモデルを介してUserとTag間の間接的な一対一関係を確立しています。
has_many :through
has_many :throughは、1対多のつながりの2つのモデルの間に第3のモデルが紐づいており、それを経由して相手モデルの複数のインスタンスとマッチします。
1人の学生が複数の授業を受講し、1つの授業に複数の学生が参加するというパターンを考えます。 その場合以下のように構造を表現することが出来ます。
class Student < ApplicationRecord
  has_many :enrollments
  has_many :courses, through: :enrollments
end

class Enrollment < ApplicationRecord
  belongs_to :student
  belongs_to :course
end

class Course < ApplicationRecord
  has_many :enrollments
  has_many :students, through: :enrollments
end
Enrollmentという中間テーブルを作成します。
中間テーブルには外部キーをそれぞれ設定します。今回の場合にはStudentとCourseの外部キーをそれぞれ登録して対象のデータを絞り込めるようにします。
StudentとCourseは中間テーブルと1対多の関係になっていて、Enrollmentという中間テーブルを経由して他テーブルのデータを取得します。
下記方法で生徒が受けているコースの一覧を取得できます。
student = Student.find(1)
courses = student.courses
has_one :throughの場合には、PostモデルがUserとTagの間の仲介モデルとして機能していました。
has_many :throughの場合には、throughで指定されたPostモデルがUserとTagの間の中間テーブルとして機能しています。
中間テーブルはこちらの記事で説明しているので、合わせて確認してみてください!
has_and_belongs_to_many
has_and_belongs_to_manyはモデル同士が多対多の関係の場合に使用します。
has_many :throughとは違い、中間テーブルを作成しません。 has_many :throughで使用したStudentとCourseの例で考えます。
class Student < ApplicationRecord
  has_and_belongs_to_many :courses
end

class Course < ApplicationRecord
  has_and_belongs_to_many :students
end
Studentは複数のCourseを受けて、Courseは複数のStudentが参加しているという多対多の関係をhas_and_belongs_to_manyで表しています。
ここで、has_many :throughとhas_and_belongs_to_manyは同じ関連付けをしていることがわかりますが、どちらを選択した方がいいでしょうか?
has_many :throughとhas_and_belongs_to_manyの大きな違いは中間モデルが存在するかどうかです。
has_and_belongs_to_many の場合、中間モデルは存在していません。 そのかわり、結合用のテーブルが存在するのですが、結合用のテーブルは外部キーのみ登録されるものです。
has_many :through はモデルに情報が全て明示的に残されています。 また、中間テーブルを作成するので、そこに外部キー以外の情報を含めることも可能です。(カスタマイズしやすいです)
個人的にはhas_many :throughで中間テーブルを作成する方法で優先的に考えたいと思っています。
理由としては、まず、id(プライマリーキー)をもたせる事ができないので、indexをはることができないので、レコード量が多いとき時間かかる可能性があるからです。 そして、開発していく中で、少なくとも結合テーブルの属性が増える可能性は十分にありえます。でもhas_and_belongs_to_many はカスタマイズできないので不安です。
まとめ
関連付けの方法をいくつか説明しました。 DBやモデルの設計をしていく中でどの方法を選択するかは決まっていくと思いますので、おおまかな方法を知っておく必要があると思います。
参照
Railsでの中間テーブルについて
今回はRailsでの中間テーブルについてまとめます。
中間テーブルは、多対多の関係を持つ2つのモデル間に配置されるテーブルのことを指します。これは、あるモデルと別のモデルの間に多対多の関係が存在する場合に使用されます。
今回は一例としてユーザーとタスクの関係を用いて説明します。
ユーザーは複数のタスクを担当でき、1つのタスクは複数のユーザーがアサインされている場合があるような多対多の関係を持つ2つのモデルという前提です。
テーブル設計
最初に、なぜ中間テーブルを作るのでしょうか?
中間テーブルは必ず作らないとエラーになるとかそんなことはありません。 ただし、中間テーブルを用いなければ非常に冗長なテーブル設計となってしまいます。
サンプルとして、Userテーブルは簡易的に用意します。
| id | name |
|---|---|
| 1 | ユーザー1 |
| 2 | ユーザー2 |
| 3 | ユーザー3 |
| 4 | ユーザー4 |
そして、Taskテーブルも作成します。
| id | name |
|---|---|
| 1 | タスク1 |
| 2 | タスク2 |
| 3 | タスク3 |
中間テーブルを作成しない場合には、Userテーブルでユーザーが担当するタスクを管理、もしくはTaskテーブルで担当しているユーザーを管理する事になります。 下記の例では、Userテーブルでユーザーが担当するタスクを管理しています。 これではユーザーが新しいタスクが作られるたびに、Userテーブルのカラムを増やす事になるため、テーブル設計時にカラム数を決めることができません。
| id | name | task1 | task2 | task3 |
|---|---|---|---|---|
| 1 | ユーザー1 | タスク1 | タスク2 | タスク3 |
| 2 | ユーザー2 | タスク1 | タスク2 | |
| 3 | ユーザー3 | タスク2 | ||
| 4 | ユーザー4 | タスク3 |
なので、多対多の関係を構成するときには、UserとTaskのような別々のテーブルがあって、「Userは複数のTaskを担当する」、「TaskにはUserが複数参加する」という状態をうまく表現するためにUserTaskのような中間テーブルを使います。

UserTask中間テーブルは下記のイメージで作成されます。
| id | user_id | task_id | 説明 |
|---|---|---|---|
| 1 | 1 | 2 | ユーザー1はタスク2を担当している |
| 2 | 2 | 1 | ユーザー2はタスク1を担当している |
| 3 | 4 | 3 | ユーザー4はタスク3を担当している |
| 4 | 4 | 1 | ユーザー4はタスク1を担当している |
中間テーブルの作成
Modelの作成
実際にModelを作ってみましょう。(Userモデル・Taskモデルは作成済みとします)
まずは中間テーブルのUserTaskモデルを作成します。
rails g model UserTask
作成したら、db/migrate配下にマイグレーションファイルが作成されているはずなので、下記のように設定を追加します。
class CreateUserTasks < ActiveRecord::Migration[7.0]
  def change
    create_table :follow_relationships do |t|
      t.references :user, foreign_key: true
      t.references :task, foreign_key: true

      t.timestamps

      t.index %i[ user_id task_id ], unique: true
    end
  end
end
今回はuser_idとtask_idを参照できればいいので、t.referenceを使ってidをカラムに入れられるようにします。
そして、UserテーブルとTaskテーブルを使うので、それぞれt.references :userとt.references :taskと記述します。
それぞれのidは存在しない値は入って欲しくないので、外部キー制約をつけます。
外部キーの制約はforeign_key: trueで設定します。
これに加えて、user_idとtask_idの組み合わせはたった1つである必要があります。user_id=1のユーザーが、task_id=2のタスクを担当しているという状況は1つだけです。
その制約をt.index %i[ user_id task_id ], unique: trueで追加しています。
最後に、rails db:migrateコマンドでマイグレーションを実行します。
アソシエーションの追加
次にModel同士の関連性を定義します。
ユーザーは、タスクの情報を複数持っています。 つまり、Userテーブルは複数のUserTaskテーブルを持っていることになるので has_many を使って表現します。
class User < ApplicationRecord
  has_many :user_tasks
end
逆にUserTaskテーブルから見ると、Userテーブルに所属していることになるので、 belngs_to を使って表現します。
class UserTask < ApplicationRecord
  belongs_to :user
end
同様に、TaskテーブルとUserTaskの関連性も追加します。
class Task < ApplicationRecord
  has_many :user_tasks
end

class UserTask < ApplicationRecord
  belongs_to :user
  belongs_to :task
end
これだけでなく、UserがTaskテーブルは1:多数のなので、次のように定義できます。
class User < ApplicationRecord
  has_many :user_tasks
  has_many :tasks, through: :user_tasks
end
has_many :throughで中間テーブルを経由したTaskとの関連付けを定義しています。
こうすることで、userが持っているtask情報を取得することができるます。
// 関連付けの追加
class Task < ApplicationRecord
  has_many :user_tasks
  has_many :users, through: :user_tasks
end


user = User.first

// userが担当しているタスクの情報が取得できる
user.tasks
同様にTaskからユーザーの情報を取得することも可能です。
task = Task.first

// アサインされているユーザー情報が取得できる
task.users
フォロー機能の検討
次に、フォロー・フォロワーの関係性を考えます。
先ほどとの違いは、多対多のアソシエーションなのですが、 一般的な多対多のテーブルと違い、対になるテーブルがUserテーブルで同じものです。 ユーザーがユーザーをフォローし、ユーザーはユーザーにフォローされる関係です。
ここでは、中間テーブルをFollowRelationshipテーブルとします。 このテーブルには、Userのidを使ってUserのidが1のユーザーが、Userのidが2のユーザーをフォローしているといった情報を持ちます。
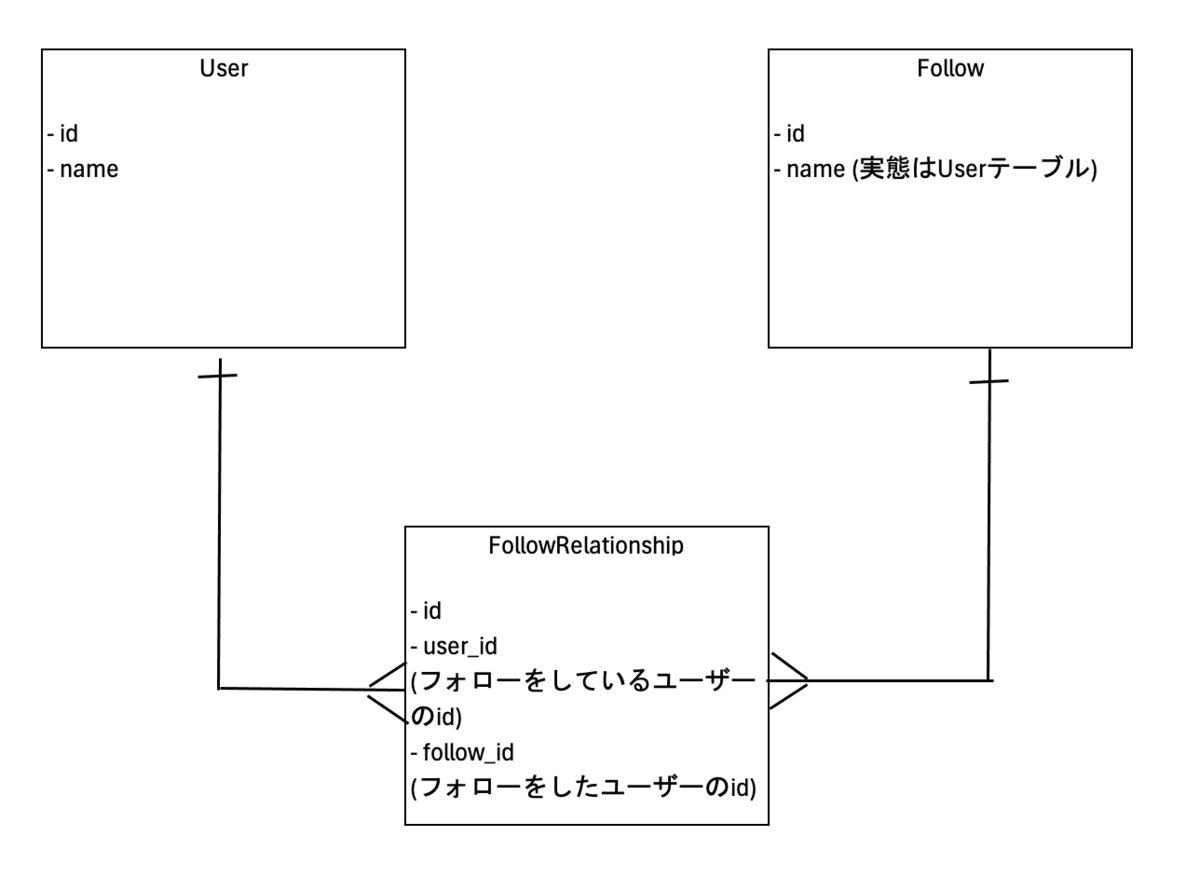
FollowRelationshipは下記のイメージです。
| id | user_id | follow_id | 説明 |
|---|---|---|---|
| 1 | 1 | 2 | ユーザー1はユーザー2をフォローしている |
| 2 | 2 | 1 | ユーザー2はユーザー1をフォローしている |
| 2 | 4 | 3 | ユーザー4はユーザー3をフォローしている |
次に中間テーブルを作成します。
class CreateFollowRelationships < ActiveRecord::Migration[7.0]
  def change
    create_table :follow_relationships do |t|
      t.references :user, foreign_key: true
      t.references :follow, foreign_key: { to_table: :users }

      t.index %i[ user_id follow_id ], unique: true

      t.timestamps
    end
  end
end
外部キーの制約はforeign_key: trueで設定できるのですが、今回はFollowテーブルという架空のテーブルがあり、その実態はUserテーブルです。
先ほどと同じやり方では存在しないFolllowテーブルを探しにいってしまいます。
なので、t.references :followの後ろにはforeign_key: { to_table: :users }と書いて、参照先のテーブルを教えてあげるようにします。
FollowRelationshipの関連性の追加は下記のようにします。
class FollowRelationship < ApplicationRecord
  belongs_to :user
  belongs_to :follow, class_name: 'User'
end
userとfollowの2つを所有していますが、followはユーザーテーブルなのでbelongs_to :followだけだと存在しないテーブルと関連付けすることになります。
そこで、class_nameを指定することでUserテーブルを参照するようにします。
class_name: "User"オプションを使用することで、followの関連付けにはUserモデルが使用されます。これにより、followはUserモデルのインスタンスとして扱われます。 class_nameを指定しない場合、デフォルトで関連付け名を基に関連するテーブルを探します。しかし、followというテーブルは存在しないため、エラーが発生します。
次にUserモデルの関連付けです。 まず、完成したものを下記に記載します。
class User < ApplicationRecord
  has_many : active_relationships, class_name: 'FollowRelationship', foreign_key: 'user_id'   →①
  has_many : passive_relationships, class_name: 'FollowRelationship', foreign_key: 'follow_id'  →②
  has_many :followings, through: : active_relationships, source: :follow  →③
  has_many :followers, through: : passive_relationships, source: :user  →④
end
少し補足します。
①は、Userモデルがフォローしている関連付けを定義しています。FollowRelationshipモデル(中間テーブル)との関連付けを行い、active_relationshipsという名前で参照します。 外部キーとしてuser_idカラムを使います。
②は、Userモデルがフォローされている関連付けを定義しています。FollowRelationshipモデル(中間テーブル)との関連付けを行い、passive_relationshipsという名前で参照します。 外部キーとしてfollow_idカラムを使います。
③は、ユーザーがフォローしているユーザーの一覧を取得するための関連付けを定義しています。Userモデルは、active_relationships経由でfollowings(フォローしているユーザー)と関連付けられます。source: :followedにより、active_relationshipsテーブルのfollowedカラムを参照します。
④は、ユーザーをフォローしているユーザー(フォロワー)の一覧を取得するための関連付けを定義しています。Userモデルは、passive_relationships経由でfollowers(フォロワー)と関連付けられます。source: :followerにより、passive_relationshipsテーブルのfollowerカラムを参照します。
sourceオプションはデータを取得しにいくテーブルを明示するためのものです。
今回は、 has_many :followingsやhas_many :followersと名前が異なるので、明示的に指定するために使用しています。
このように設定することで、user.followingやuser.followersのようにしてフォローワーやフォローしているユーザーの情報を取得できます。
参照
Rspecの使い方
今回はRspecについてまとめようと思います。
RSpecは、Rubyで書かれたアプリケーションの挙動・機能をテストするために利用されます。(テストフレームワーク)
導入
まずはRspecを使えるようにします。
group :test do
  gem "rspec-rails"
end
Gemfileにrspec-railsというGemを追加して、bundle installを行います。
Gemをインストールしたら、rails generate rspec:installコマンドでセットアップを行います。
成功すれば、specフォルダが作成されているはずなので、確認しましょう。
rails generate rspec:installを実行する前に、config/application.rbに下記設定を追加することで、specフォルダ内にデフォルトで作成されるファイルを作成されないように設定できます。
config.generators do |g|
      g.test_framework :rspec,
                       fixtures: false,   # テストデータを作るfixtureを作成しない
                       view_specs: false,   # テストデータを作るfixtureを作成しない
                       helper_specs: false,   # ヘルパー用のスペックを作成しない
                       routing_specs: false   # ルーティングのスペックを作成しない
    end
これで、RSpecを実行する準備が整いました。
テストの配置ルールと命名規則
テストを実行するためにはファイルの配置ルールと命名規則に従う必要があります。
Ruby on Railsの場合は、次のように配置します。
 spec/
   models/
      モデルファイル名_spec.rb
   controllers/
      コントローラファイル名_spec.rb
   views/
      erbファイル名_spec.rb
このように、Ruby on Railsのディレクトリ構成と同じ階層構成でspecディレクトリ配下に配置します。
Rspecの基本構造
Rspecに限らず、基本的なテストはデータを準備→確認したい処理を呼び出す→結果が想定通りか確認という流れになると思います。
その流れの中で、Rspecの書き方を見ていきます。
まずは、ファイルの先頭にはrequire 'rails_helper'をつけてください!
describe
まず、describeでテストの対象が何かを記述します。
describe "計算を確認するテスト" do
end
このように日本語でも書くことができます(もちろん、英語の可能です)
また、どのクラスのテストケースかを指定するだけでなく、 type: :modelや type: :controllerを指定することで、どのモジュールのテストかを指定できます。
controllerのテストで type: :requestを指定できます。type: :requestはURLの接続テストになるので、APIのテストという意味合いをもちます。(エンドポイントやPOST/GETなどのメソッドの種類を指定して実行します)
RSpec.describe Bookmark, type: :model do
end
context
contextは特定の条件や実施する際の条件を記載します。
describe "計算を確認するテスト" do
  context "マイナスの2つの数字の足し算" do
    calculator = Calculator.new
    result = calculator.add(-1, -2)
  end
end
contextはネストすることができるので、1つのdescribeの中に複数のcontextを記載できます。
describe "計算を確認するテスト" do
  context "2つの数字を加算" do
    context "2つのプラスの数字を加算" do
    end

    context "2つのマイナスの数字を加算" do
    end
  end

  context "2つの数字を減算" do
  end
end
it
itはアウトプットの内容を記載します。
describe "計算を確認するテスト" do
  context "マイナスの2つの数字の足し算" do
    calculator = Calculator.new
    result = calculator.add(-1, -2)

    it "-3が出力される(マイナス通しの足し算で想定通りになる)" do
       expect(result).to eq(-3)
    end
  end
end
expectメソッドの引数にテスト対象コード(オブジェクト)を渡します。
expect(...).to につづけてマッチャーを書きます。
今回はeqでresultと-3が一致するかを確認しています。
resultと-3が一致しない場合にはテストケースの実行で失敗します。
eq以外にtrueかfalseかをチェックするbe_validなどマッチャーはいろんな種類があるので、公式ドキュメントを確認するといいでしょう。(最後の参照にリンク貼ってます)
before
beforeは各テストケースの前に実行されるコードブロックです。
テストケースの前にデータの準備を行いたいパターンやいろんなテストケースで共通に行いたい処理を記載するなどができます。
describe "計算を確認するテスト" do
  before do
    # セットアップコード
  end

  it "マイナス通しの足し算" do
    # テストケースの実装
  end

  it "0が含まれた足し算" do
    # テストケースの実装
  end

  it "マイナスの数字とプラスの数字の足し算" do
    # テストケースの実装
  end
end
let
letは変数を定義する際に使用します。 describeかcontextの中でのみ使用可能です。
letとlet!の2種類あります。 letとlet!の違いは実行タイミングです。 letは利用時に実行され、let!は書かれた場所で実行されます。
letは遅延評価とも言われています。 { create(:post,user: user) }はテストが実行されるまで実際には評価されません。
let(:post) { create(:post,user: user) }
let!にするとテストが始まる前に{ create(:post,user: user) }が実行され、 その結果がlet!の後の:postにセットされます。
let!(:post) { create(:post,user: user) }
つまり、letはあるテストケース内で変数を複数回使用するが、その値が変更されない時に便利です。 そして、let!はあるテストケース内で変数の値が変更される可能性があり、テストケースごとに初期化が必要な時に便利です。
テストの実行
specフォルダに移動して、bundle exec rspecコマンドで全テストケースを実行します。
bundle exec rspec ./spec/ファイル名 というコマンドで特定のファイルに絞ってテスト実行もできます。
データ作成
テストデータを作成するときにはRspec標準で使えるfixtureに代わり、テストデータの準備をサポートしてくれるFactorybotを使用します。
fixtureを使用することもありますが、今回はFactorybotについて記載します。
Gem追加
Gemfileにfactory_bot_railsというGemを追加して、bundle installを行います。
group :test do
  gem "rspec-rails"
  gem "factory_bot_rails"
end
ファイル作成
rails g factory_bot:model モデル名
上記コマンドでfactoryファイルを作成します。test/factoriesに作成されます。
モデル作成
ファイル作成で作られたファイルがUserだと仮定して、Userのテストデータを作成します。
FactoryBot.define do
  factory :user do
    sequence :email do |n|
      "person#{n}@example.com"
    end
    password { "Password1" }
    password_confirmation { "Password1" }
    name { "test" }
    status { 0 }
end
password { "Password1" }はpasswordが固定で"Password1"という値になっていることを表しています。
sequence :email do |n|
  "person#{n}@example.com"
end
上記はnの部分が連番でデータが作成されます。
データを呼び出す
作成したテストデータを呼び出す場合には下記のようにcreate(:user)もしくは、build(:user)とすることで作成したデータを使用できます。
require "rails_helper"

describe "xxxxx" do
  before do
    @user = create(:user) #ここで定義
  end

  context "xxxxx" do
    xxxxx
  end
end
createとbuildには下記違いがあります。
create
- DB上にインスタンスを永続化する。
- DB上にデータを作成する。
- DBにアクセスする処理のときは必須。(何かの処理の後、DBの値が変更されたのを確認する際は必要)
build
- メモリ上にインスタンスを確保する。
- DB上にはデータがないので、DBにアクセスする必要があるテストのときは使えない。
- DBにアクセスする必要がないテストの時には、インスタンスを確保する時にDBにアクセスする必要がないので処理が比較的軽くなる。
さらに、データを上書きすることもできます。
@user = create(:user, name: "test更新")
このようにすることで、nameがtest更新のユーザーデータを作成できます。
trait
traitはパターンA、B 、C などデータをパターン分けして準備できる機能です。
FactoryBot.define do
  factory :user do
    sequence :email do |n|
      "person#{n}@example.com"
    end
    password { "Password1" }
    password_confirmation { "Password1" }
    name { "test" }
    status { 0 }

    trait :fixed_id do
        id { 100 }
    end
end
上記は先ほどUserモデルにidが固定バージョンのデータを追加しました。
let(:user) { create(:user, :fixed_id) }のようにfixed_idを追加することで指定したデータにできます。
こうすることで、毎回idが固定は困るけど、特定のケースではidを固定で使用したいなど使い分けができます。
複数データを作成する
複数データを作成する場合に、個数分createするのは骨が折れる作業です。
そこで、FactoryBotのcreate_listメソッドを使って複数個のデータを一気に作成できます。
users = create_list(:user, 5)
または、Userの生成時に、Taskも一緒に生成したい場合には下記のようにすることができます。
trait :with_tasks do
      after(:create) do |user|
        create_list(:task, 5, user:)
      end
    end
TransientとEvaluatorを使用した関連データの生成
trasientはファクトリの生成時に動的なデータにする属性です。
transientをcallback関数内で参照したい場合、evaluatorを使います。
callback関数のブロック引数でevaluatorを宣言することで、transientの値を参照することができます。
FactoryBot.define do
  factory :user do
  end

  trait :with_tasks do
      transient do
        tasks_count { 5 }
      end
      after(:create) do |user, evaluator|
        # evaluatorを経由して、transientのtasks_countを参照している
        create_list(:knowledge, evaluator.tasks_count, user:)
      end
    end
end
上記はUserのwith_tasksで、生成するtaskの数を指定したい場合の定義です。
画像のサンプルを用意
画像のサンプルを用意する場合にはspec/fixtures配下に画像を置いてください。
画像のアップロードを行うテストはfixture_file_uploadメソッドを使用します。
例えば、下記はアップロードされた画像とみなすことができます。
let(:image1) { fixture_file_upload("spec/fixtures/image.png", "image/png") }
おまけ
type: :requestでheaderを指定するのは簡単ですが、type: :controllerの場合には少し工夫が必要です。
describe 'Sample' do
    let(:header) { { 'X-Requested-With': "XMLHttpRequest" } }
    let(:params) { { 'TEST': "SAMPLE" } }

    it 'set header' do
      post 'path/to/endpoint', params: params, headers: header
      expect(response.status).to eq 200
    end
end
type: :controllerの場合にはheaderを指定するだけで適用されますが、type: :controllerでは指定できません。
require 'rails_helper'

RSpec.describe Api::LoginsController, type: :controller do

   let(:header) { { 'X-Requested-With': "XMLHttpRequest" } }

  describe 'logout' do
    it 'returns status 204' do
      request.headers.merge!(header)
      post :logout

      expect(response.status).to eq(204)
    end
  end
end
end
type: :controllerで使用する場合にはrequest.headersに追加したいヘッダー情報をマージしましょう。
参照
Vue.jsでのhistoryモードについて
今回はVue.jsでのhistoryモードについて記載しようと思います。
というのも、vue-routerを使ってページリロードしたときに404になることがありました。(historyモードの設定をしていました)
調べてみるとhistoryモードが関連しているようでした。
vue-routerのモードについて
まずは、vue-routerではhistoryモードについて説明します。 historyモードには数種類あります。
hashモード
まずはhashモードについてです。
hashモードではURLが「http://localhost:8080/#/sample」のようにhash付きで表示されます。
hashモードはルーティングにURL hashを使用しています。 この形式で入力されるとvue-routerは、urlの#を見つけてそれより先の文字列を元に動的にコンポーネントを出し分けます。
例えば、http://localhost:8080/#/sampleというURLの場合、ブラウザはこのURLのフラグメント部分("/sample")を認識し、Vue Routerがこれを処理します。 しかし、実際にサーバーに送信されるURLは、http://localhost:8080/ です
つまり、サーバーにはフラグメント部分が含まれないため、特別な設定をする必要がありません。ブラウザ側で完結して処理されるため、サーバー側の設定は不要です。
HTML5モード
一方で、HTML5モードではURLは「http://localhost:8080/sample」のようにhashは無しで表示されます。
HTML5モードではlocalhostにリクエストを送信する際は、ローカルサーバがindex.htmlを返すようになっています。 ホスティングサービスを利用する際は、index.htmlを返すように設定しなければならないので注意が必要です。
vue-router のデフォルトは hashモードですが、下記のようにモードを変更することはできます。(index.jsに定義)
const router = createRouter({
  history: createWebHistory(),
  routes,
});

export default router
createWebHistory()はHTML5モードを指定します。
404になる仕組み
では、vue-routerを使用したときにリロードで404になるのはなぜでしょうか?
先ほども少し触れていますが、リロードで404になるのはHTML5モードのときです。 hashモードでは発生しません。
また、ローカルで開発時は発生しないはずで、ホスティングサービスを使用してデプロイしたら発生します。
一般的な Vue アプリケーションでは、 index.htmlと呼ばれる単一の HTML エントリーポイントがあります。 サーバーは、すべてのリクエストに対して index.htmlにリダイレクトして、ルーティングの処理を行う必要があります。
ローカル環境では、Vite(またはwebpack)開発サーバーが処理してくれますが、本番環境ではWebサーバーを自分で構成する必要があります。
index.htmlビルドを実行すると、dist/index.htmlというビルド済みコピーが作成されるはずです。
本番環境では、dist/index.htmlのみ存在することになります。
例えばログイン画面(https://sample.com/login)に直接アクセスしようとした場合、ユーザからのアクセスを受けたサーバはindex.htmlを経由せずlogin.htmlへリクエストを行おうとします。
ただし、アプリはSPAで実装しているためデプロイをしている実体ファイルはjsやcssや画像ファイルなど除いてindex.htmlのみです。
そのためリクエストを受けるlogin.htmlが存在しないので、ページリロードや直接URLを入力してアクセスするした際に404となります。
vue-routerを使ってページリロードしたときの404対策
ここまでで404になる仕組みはわかったと思いますが、じゃあどうすればいいのでしょうか?
公式に記載はあるのですが、サーバーでの対策が必要になります。
URLがどの静的なアセットにもマッチしなかった時はindex.htmlページで受け付けるように設定します。
どのサーバーを使用しているかによって変わるので、公式のドキュメントにあるApacheの設定とVercelでのRewriteのリンクを参照に載せています。
サーバー側のWebサーバー設定で、存在しないURLをVueアプリのエントリーポイントにリダイレクトする設定を行っています。
リンクにご自身で使用しているサーバーの対策の記載がない場合には、Rewriteで検索したら見つかると思いますので試してみてください!
番外編
ここまでで、ページリロードしたときに404にならないように設定を変更しました。 ただ、意図的に404の場合にはカスタマイズした画面を表示したい場合があると思います。 例えば、削除されたデータを参照しようとするとデータがないので、404のエラーページを表示するなどです。
その場合に404でもindex.htmlを見るので初期ページが表示されるはずです。 そうならないように下記のようなルーティングを追加できます。
const router = new VueRouter({
  mode: 'history',
  routes: [{ path: '*', component: NotFoundComponent }]
})
URLをチェックして、マッチしなかった場合に 404 を返答します。 「*」でワイルドカードのパスを作り、どのパスにもマッチしなかった時のビューに飛ばすことができます。
